B2B SaaS & Дашборди
Дизайн інтерфейсів для AI-сервісів та автономних агентів: як керувати діями нейромережі без страху помилки — вартість розробки та ROI
Чому 80% AI-стартапів втрачають платних підписників на першому тижні через синдром «чорної скриньки» та витрати на повторну генерацію токенів
За аналітичними звітами Gartner та RAND Corporation, до 80–85% корпоративних AI-ініціатив та автономних агентів не доходять до масштабованого продакшену або провалюють економіку утримання (Retention), причому головна причина криється не в якості базових моделей (Claude 3.7 Sonnet, GPT-4o чи Gemini 2.5 Pro), а в архітектурі інтерфейсу. Коли фаундер загортає потужний мультиагентний бекенд у примітивне текстове поле чат-бота, він перекладає всю когнітивну складність промпт-інжинірингу на плечі кінцевого B2B-користувача. Клієнт не знає, які параметри вводити, панікує під час 18-секундної затримки виконання (Latency), боїться, що автономний агент надішле клієнтам галюцинацію або зіпсує робочу базу даних, і після 3–4 невдалих спроб повторної генерації (Re-prompting) скасовує підписку.
Ще гірше виглядає внутрішня юніт-економіка такого продукту: кожна ітерація сліпого переписування промпта у вікні чату примушує LLM-модель заново проганяти весь контекстний буфер (від $3.00 до $15.00 за мільйон вихідних токенів на флагманських reasoning-моделях), що з'їдає до 45% валової маржі (Gross Margin) SaaS-сервісу. У цьому інженерному посібнику ми розберемо, як проектується комерційний дизайн інтерфейсів для штучного інтелекту ($7,000–$20,000 під ключ): від заміни «німого чату» на структуровані патерни генеративного ui до побудови шлюзів схвалення дій (human in the loop інтерфейс), які підвищують конверсію з тріалу в оплату в 2.6 раза.
Крах стандартного чат-бота: чому вікно чату більше не підходить для складних AI-продуктів
Дослідження Nielsen Norman Group (NN/g) підтверджують фундаментальний парадокс: порожнє текстове поле з курсором («Запитайте будь-що...») має найвищий поріг когнітивного тертя серед усіх відомих UI-компонентів. У B2B-сегменті фінансовий аналітик, рекрутер чи менеджер з продажу не хоче писати есе-інструкції для нейромережі — йому потрібен детермінований бізнес-результат за 3 кліки. Саме тому зрілий ux для ai продуктів та стартапів переходить від парадигми Conversational Chat до архітектури Structured Canvas & Intent Controls.
1. Декомпозиція промпта в параметричні контролери: досвід проєкту AImReply
Замість того щоб змушувати користувача вручну прописувати в чаті тон листа, роль відправника, мову, довжину відповіді та ключові тези, інженерний інтерфейс виносить ці змінні у швидкі візуальні селектори (Pills, Segmented Toggles, Sliders), які на бекенді компілюються у бездоганний системний JSON-промпт.
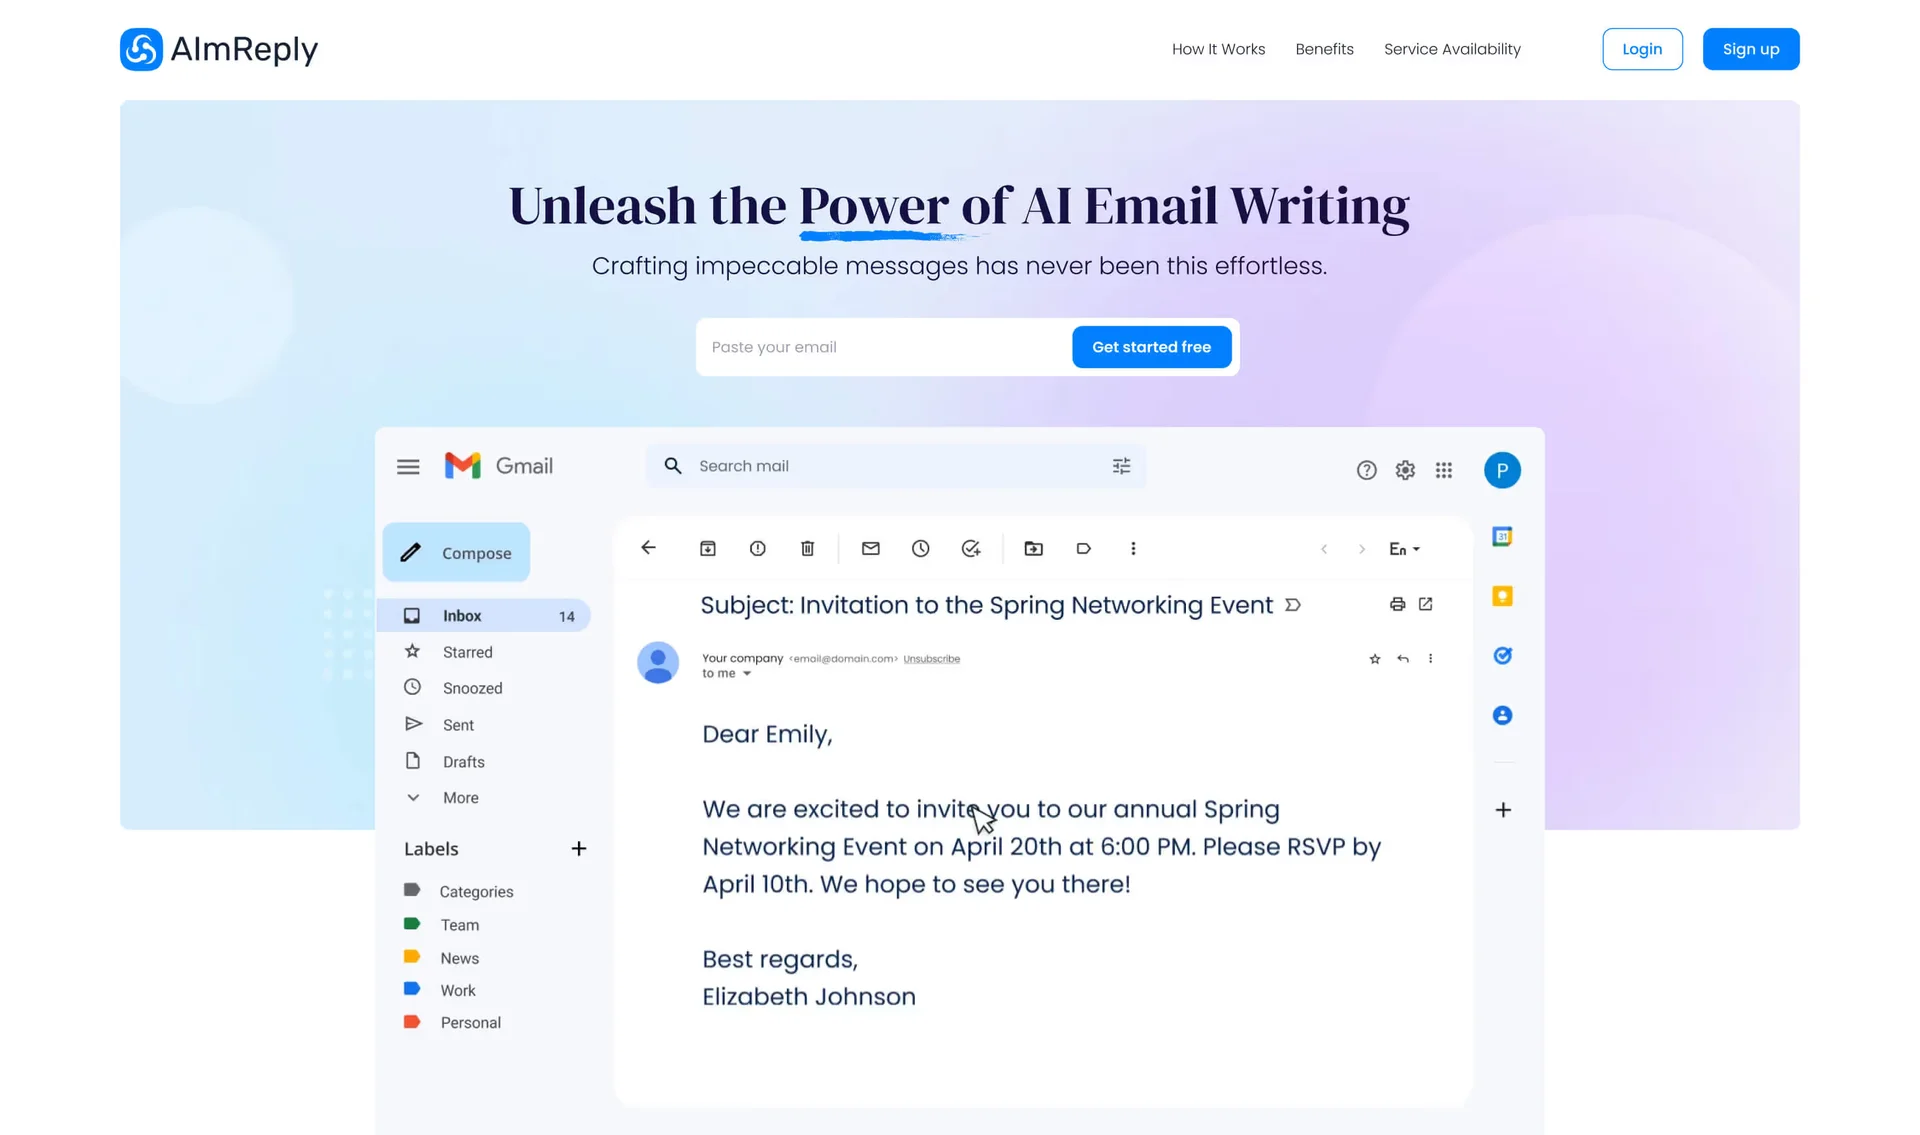
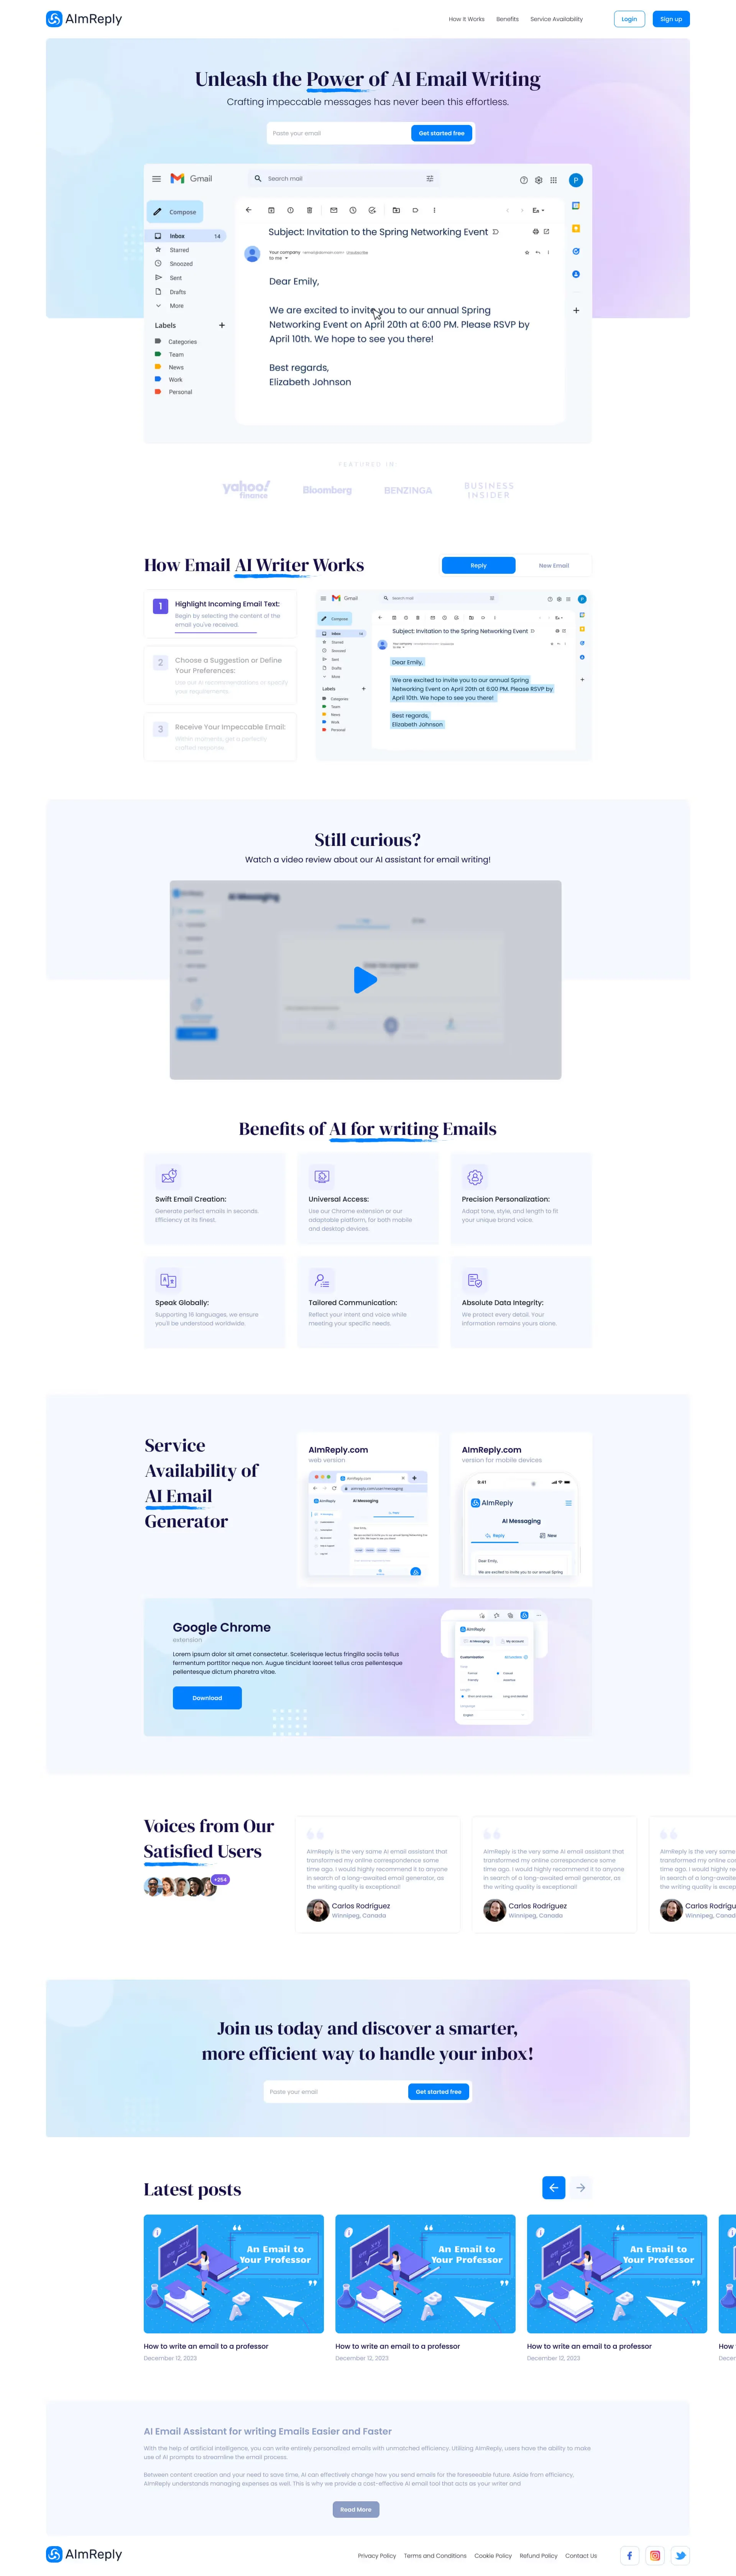
Саме таку систему керування генерацією ми заклали під час проєктування продуктової вітрини та демонстрації воркфлоу для AI-асистента ділового листування AImReply. Щоб усунути страх «чистого аркуша» у поштовому клієнті, вже на першому екрані ми продемонстрували роботу AI-модуля безпосередньо всередині інтерфейсу вхідних листів Gmail із готовим вікном генерації відповіді, а нижче на сторінці розгорнули наочний 3-кроковий процес налаштування параметрів тональності для вебверсії, мобільного додатка та розширення Google Chrome:
2. Таблиця порівняння: Сирий Чат-бот (Chat Wrapper) проти AI-Native Workspace з Human-in-the-Loop
Нижче наведено порівняння двох архітектурних підходів до побудови AI-сервісів та їхній прямий вплив на метрики утримання користувачів і витрати на інфраструктуру LLM. Детальніше про проєктування складних SaaS-систем читайте у нашому профільному хабі Складні веб-сервіси, B2B SaaS та дашборди.
| Параметр архітектури / Бізнес-метрика | Архітектура А: Стандартний Чат-бот (Text Prompt Wrapper) | Архітектура Б: AI-Native Інтерфейс (Generative UI + HITL) |
|---|---|---|
| Механіка постановки задачі | Ручне написання текстових промптів у порожнє поле | Параметричні селектори, контекстні дії та пресети в 1 клік |
| Час до отримання першої цінності (TTV) | 8–14 хвилин (підбір формулювань, боротьба з галюцинаціями) | 45–90 секунд (готовий структурований артефакт з першої спроби) |
| Кількість повторних генерацій (Re-prompts) | 4.2–6.5 запитів на одну задачу (спалювання контекстного вікна) | 1.1–1.4 запити (точкове редагування окремого блоку без перезапуску) |
| Витрати на токени LLM API (COGS на юзера) | $14.50–$28.00/міс (неконтрольовані цикли міркувань агента) | $3.80–$6.20/міс (кешування контексту та маршрутизація моделей) |
| Сприйняття затримки 10–25 секунд | Сліпий спінер завантаження → 38% закриття вкладки | Streaming-скелетон кроків думки (`Аналіз бази` → `Звірка`) → < 4% відмов |
| Безпека виконання автономних дій | Ризик незворотного видалення чи відправки сирих даних | Шлюз Human-in-the-Loop (`Approve` / `Diff Edit` / `Rollback`) |
| Конверсія з Free Trial у платну підписку | 3.5%–6.0% (високий відтік у перші 48 годин) | 14.5%–21.0% (висока довіра корпоративних команд і CFO) |
Патерни керування затримкою (Streaming UX): скелетони думок, кроки міркувань та прогрес виконання
Коли класичний вебдодаток виконує SQL-запит до бази даних, відповідь надходить за 80–200 мілісекунд. Коли ж автономний AI-агент планує ланцюжок дій (Chain-of-Thought), звертається до векторного сховища (RAG), викликає 3 зовнішні API-інструменти та верифікує відповідь, сумарна затримка (End-to-End Latency) становить від 8 до 35 секунд. За законами когнітивної психології Якоба Нільсена, будь-яке очікування понад 10 секунд без прозорого зворотного зв'язку змушує людину вважати, що система зависла.
1. Візуалізація дерева міркувань (Chain-of-Thought Stepper) замість кругового спінера
Головне правило інженерного Streaming UX: перетворіть час технічного очікування на демонстрацію цінності роботи агента. Замість статичного індикатора `Loading...` ми будуємо живий каскадний лог виконання (Reasoning Accordion), який оновлюється через Server-Sent Events (SSE) або WebSockets кожні 400–800 мс:
Фаза декомпозиції (`0.0s – 1.5s`): Миттєвий рендер структурного скелетона майбутньої таблиці чи документа ще до надходження першого токена (Time-to-First-Token < 300 мс).
Прозорі виклики інструментів (`1.5s – 8.0s`): Відображення компактних бейджів активних процесів у реальному часі: `✓ Проскановано 42 PDF-специфікації` → `⟳ Звірка цін через API постачальника...` → `✓ Перевірено комплаєнс-обмеження`.
Асинхронне дозавантаження блоків (Progressive Hydration): Користувач може почати читати й редагувати перший готовий розділ звіту, поки агент у фоновому режимі дораховує фінансову таблицю нижче за скролом.
2. Контекстний оверлей та вбудована оркестрація без виходу з робочого вікна: кейс simpl.cx
Найкращі інтерфейси керування ai агентами не змушують співробітника перемикатися між робочою CRM/ERP та окремою вкладкою асистента — вони вбудовуються безпосередньо поверх цільового продукту як розумний шар супроводу (Copilot Overlay).
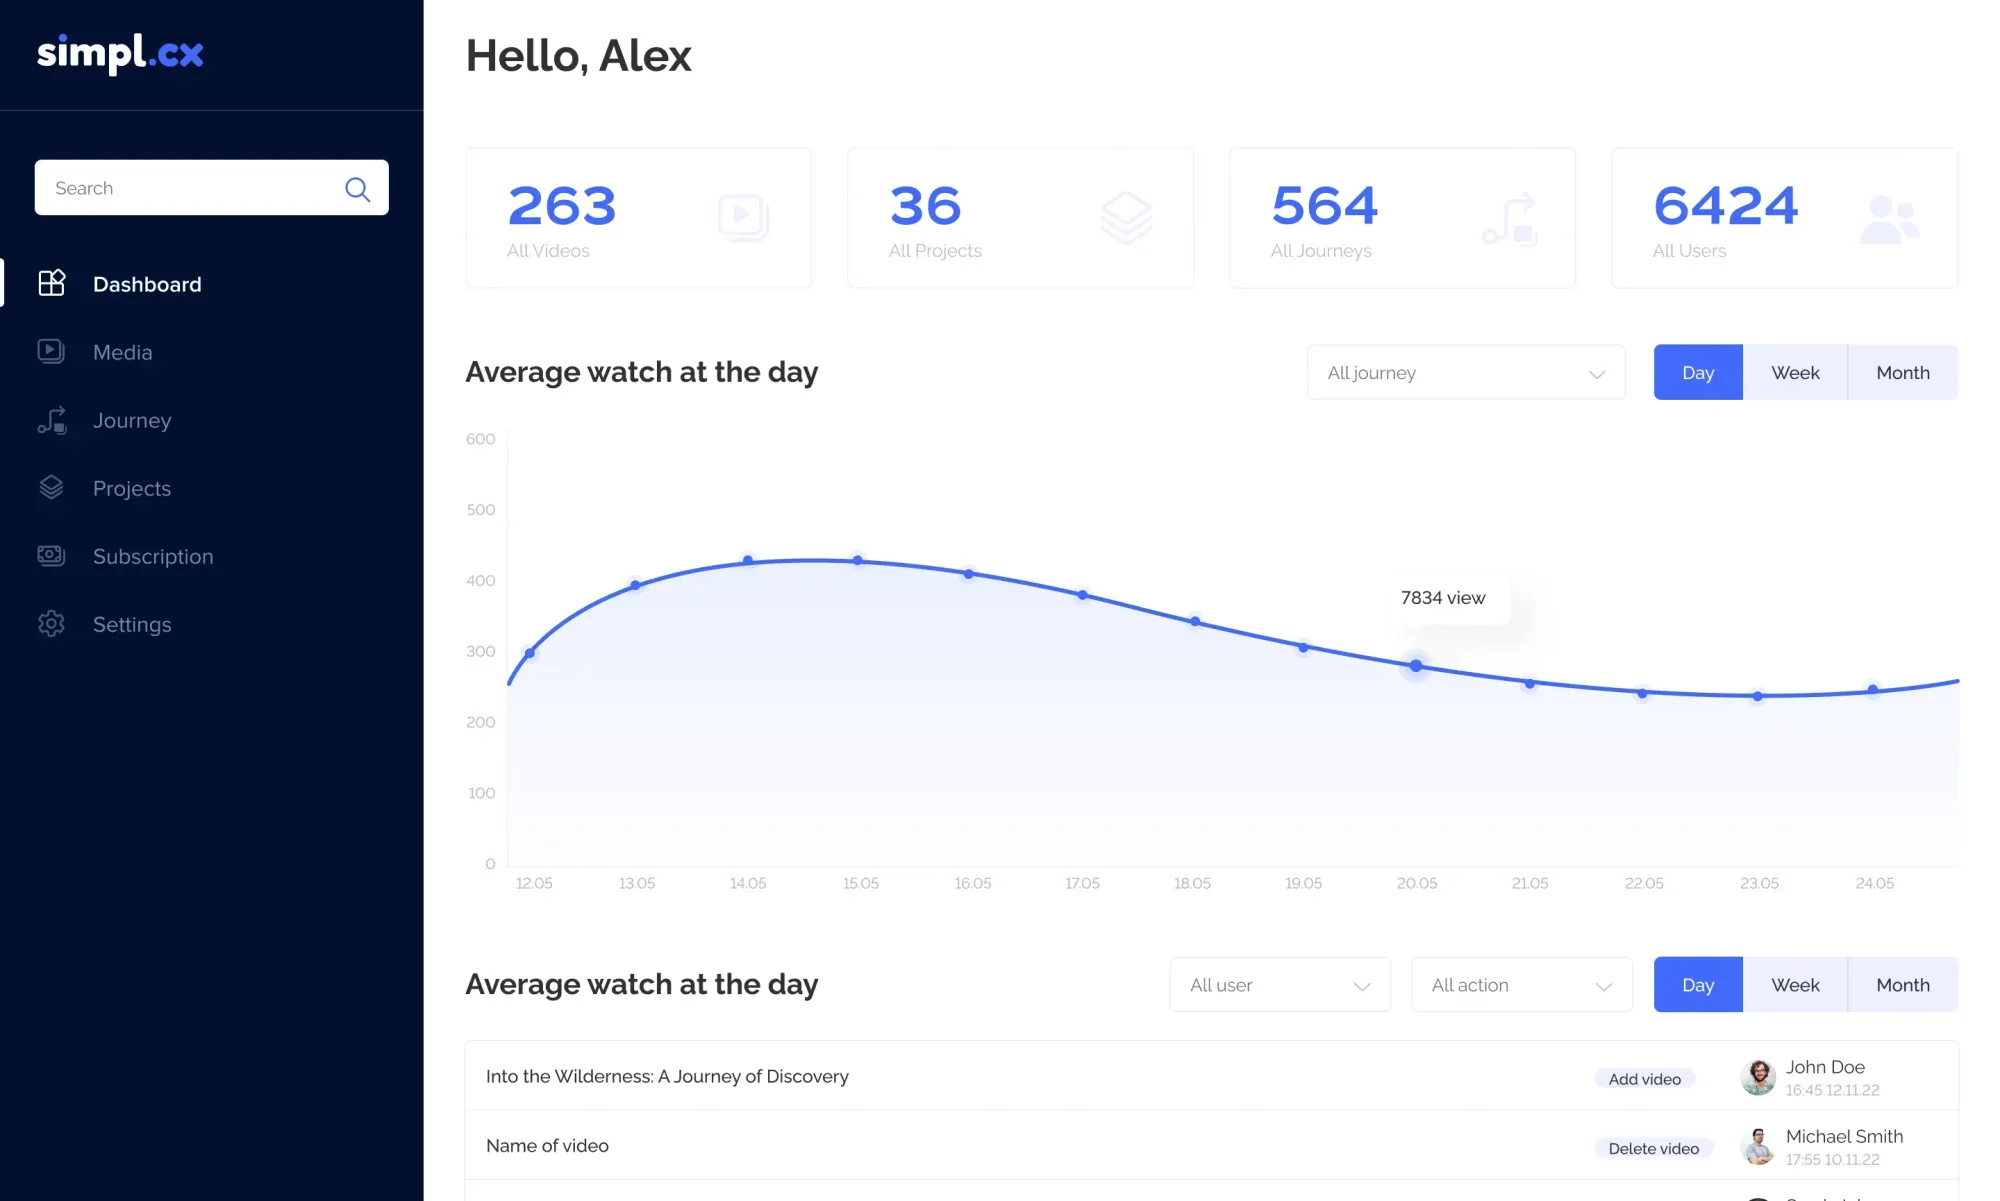
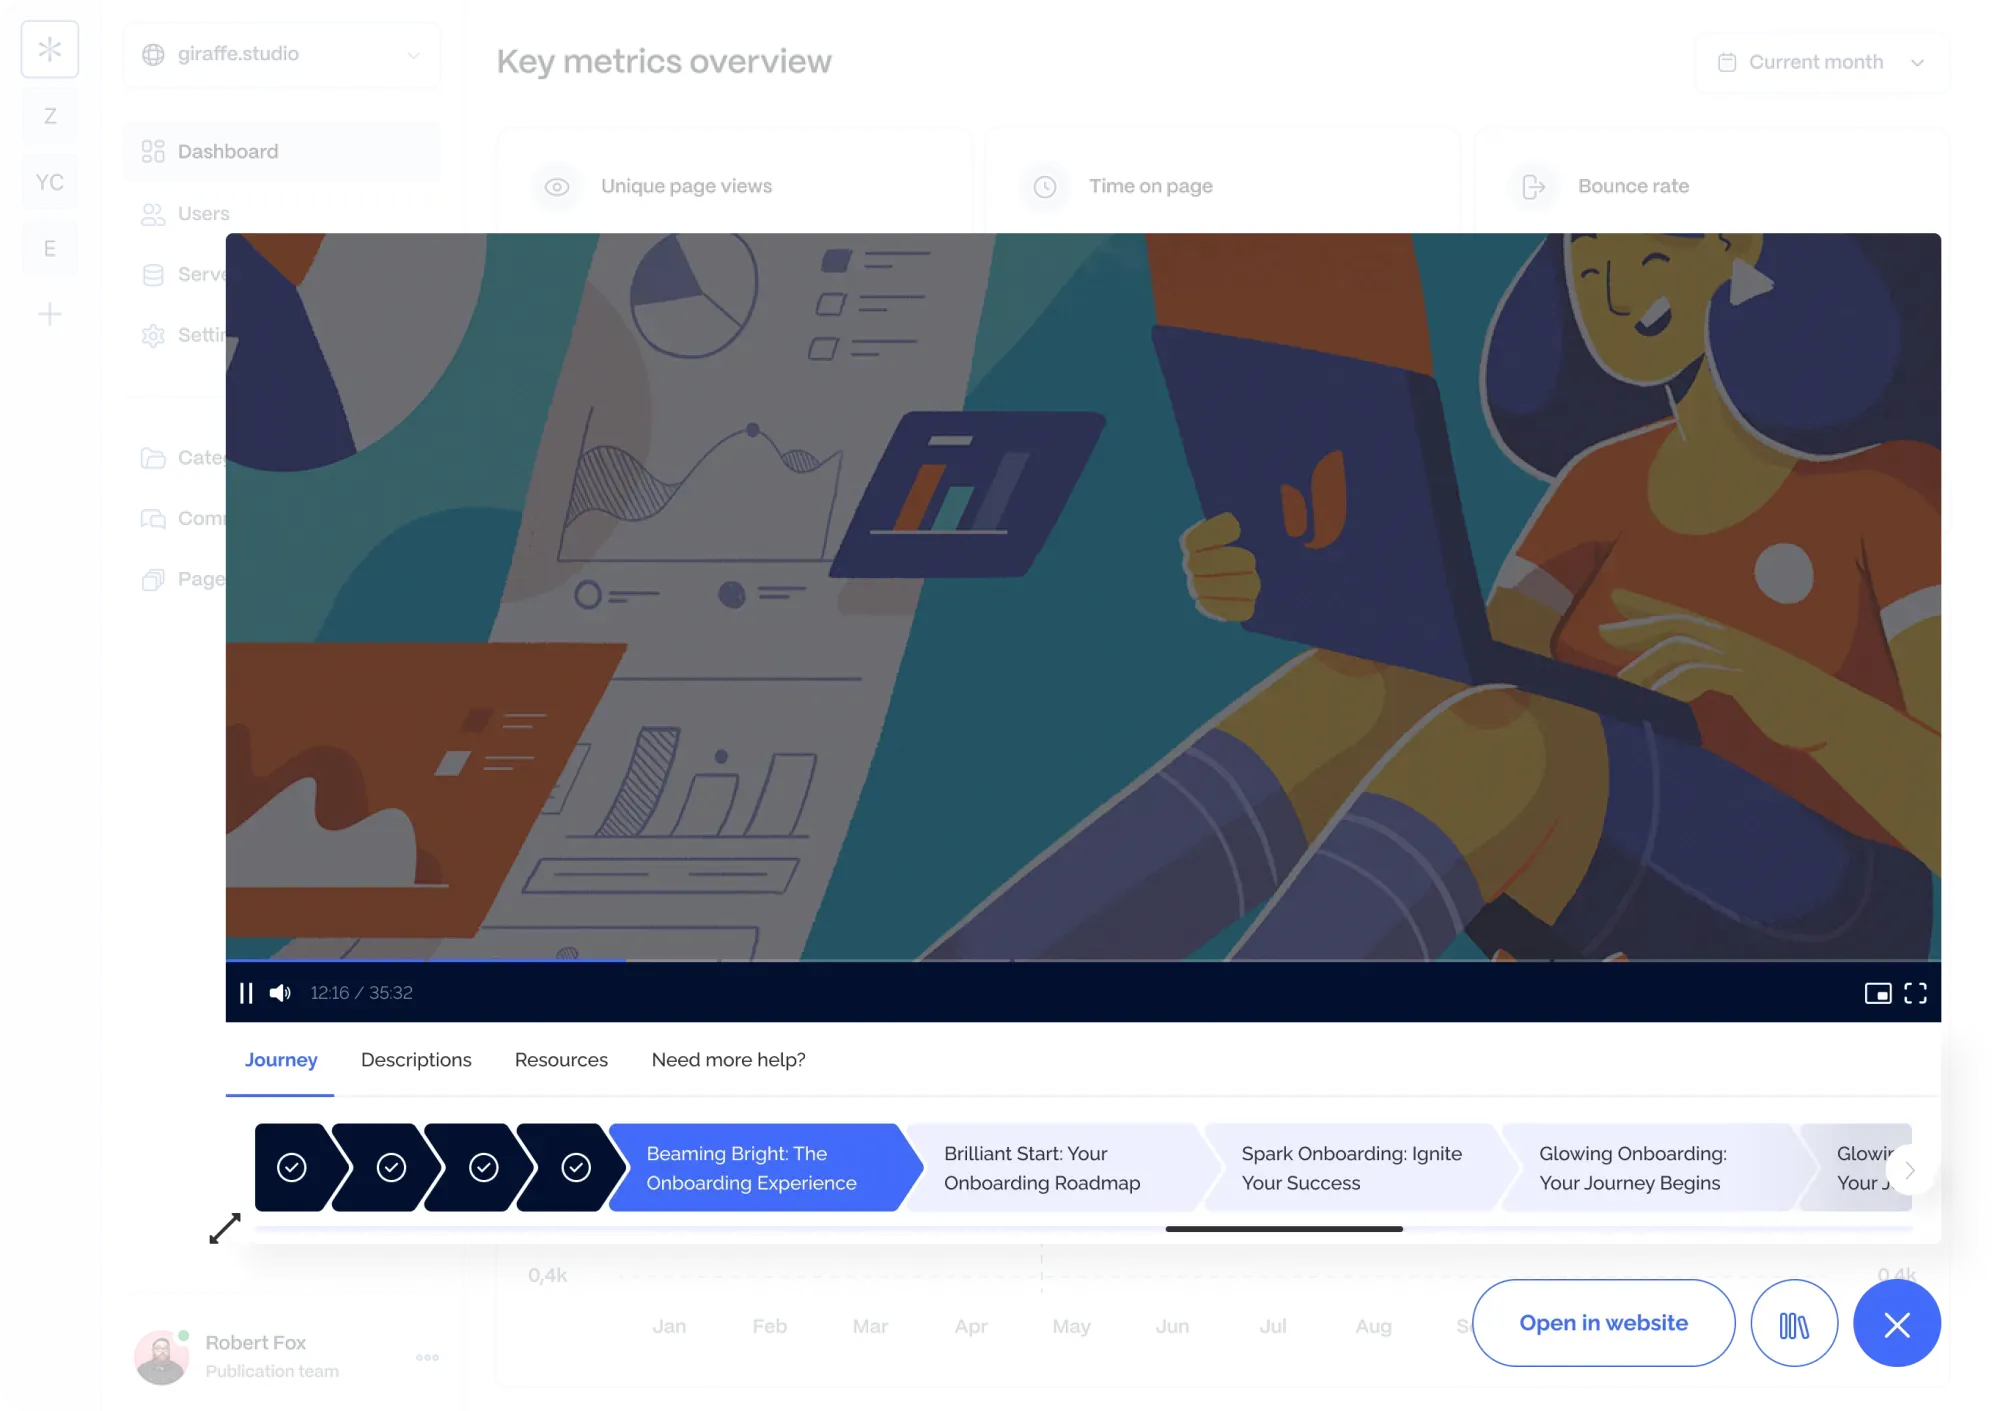
Саме таку архітектуру контекстного вбудованого асистента та покрокового супроводу ми розробили для B2B SaaS-платформи simpl.cx. Ми спроєктували полегшений JS-віджет, який розгортається поверх будь-якого клієнтського вебдодатка без перезавантаження сторінки: користувач бачить чіткий прогрес-бар поточного сценарію, інтерактивні підказки, прикріплені документи (Resources) та контрольні точки перевірки (Checkpoints), маючи змогу в будь-яку секунду поставити процес на паузу або викликати живого спеціаліста:
Концепція Human-in-the-Loop: контрольні точки схвалення дій агента (Approve / Edit / Reject)
Головний бар'єр впровадження автономних агентів у фінтех, бухгалтерію, B2B-продажі та медицину — це асиметрія ціни помилки. Якщо AI-агент автоматично виконає 99 правильних дій, але на 100-й самовільно відправить клієнту договір із неправильною сумою або видалить рядок із продакшн-бази, бізнес зазнає прямих збитків. Саме тому проєктування сучасних автономних систем базується на трирівневій моделі Graduated Autonomy (Градуйована автономія) та шлюзах Human-in-the-Loop (HITL).
1. Світлофор повноважень агента та інтерфейс порівняння станів (Diff Viewer)
Ми ніколи не проектуємо автономність за бінарним принципом «або все вручну, або повний автопілот». Кожна дія агента класифікується за рівнем фінансового та операційного ризику:
Зелена зона (Повна автономія + Undo): Безпечні операції читання, класифікації, тегування вхідних лідів або підготовки чернеток виконуються у фоні автоматично. У стрічці активності залишається кнопка `↺ Відкотити стан (Rollback)` в один клік.
Жовта зона (Пакетне підтвердження — Batch Review): Агент готує 25 персоналізованих комерційних пропозицій або змін у картках товарів і складає їх у буфер очікування (`Staging Queue`). Менеджер бачить наочне порівняння «Було → Стане» (Inline Diff з підсвіткою змінених цифр зеленим і видалених червоним), за потреби править одне число прямо в рядку і натискає `Підтвердити всі 25`.
Червона зона (Жорсткий шлюз — Hard Approval Gate): Будь-яка дія, що ініціює списання коштів, зміну цін у прайсі, надсилання зовнішнього листа клієнту або перезапис бази даних, фізично зупиняє виконання воркфлоу і виводить висококонтрастну картку рішення з трьома кнопками: `[ ✓ Схвалити дію ]`, `[ ✎ Редагувати параметри ]` та `[ ✕ Відхилити й уточнити правило ]`.
2. Конструктор контрольних точок (Checkpoints) та шлюзів перевірки
Щоб керівник команди міг самостійно налаштовувати, на якому саме етапі процес має зупинятися для перевірки людиною, у системі проєктується візуальний редактор сценаріїв.
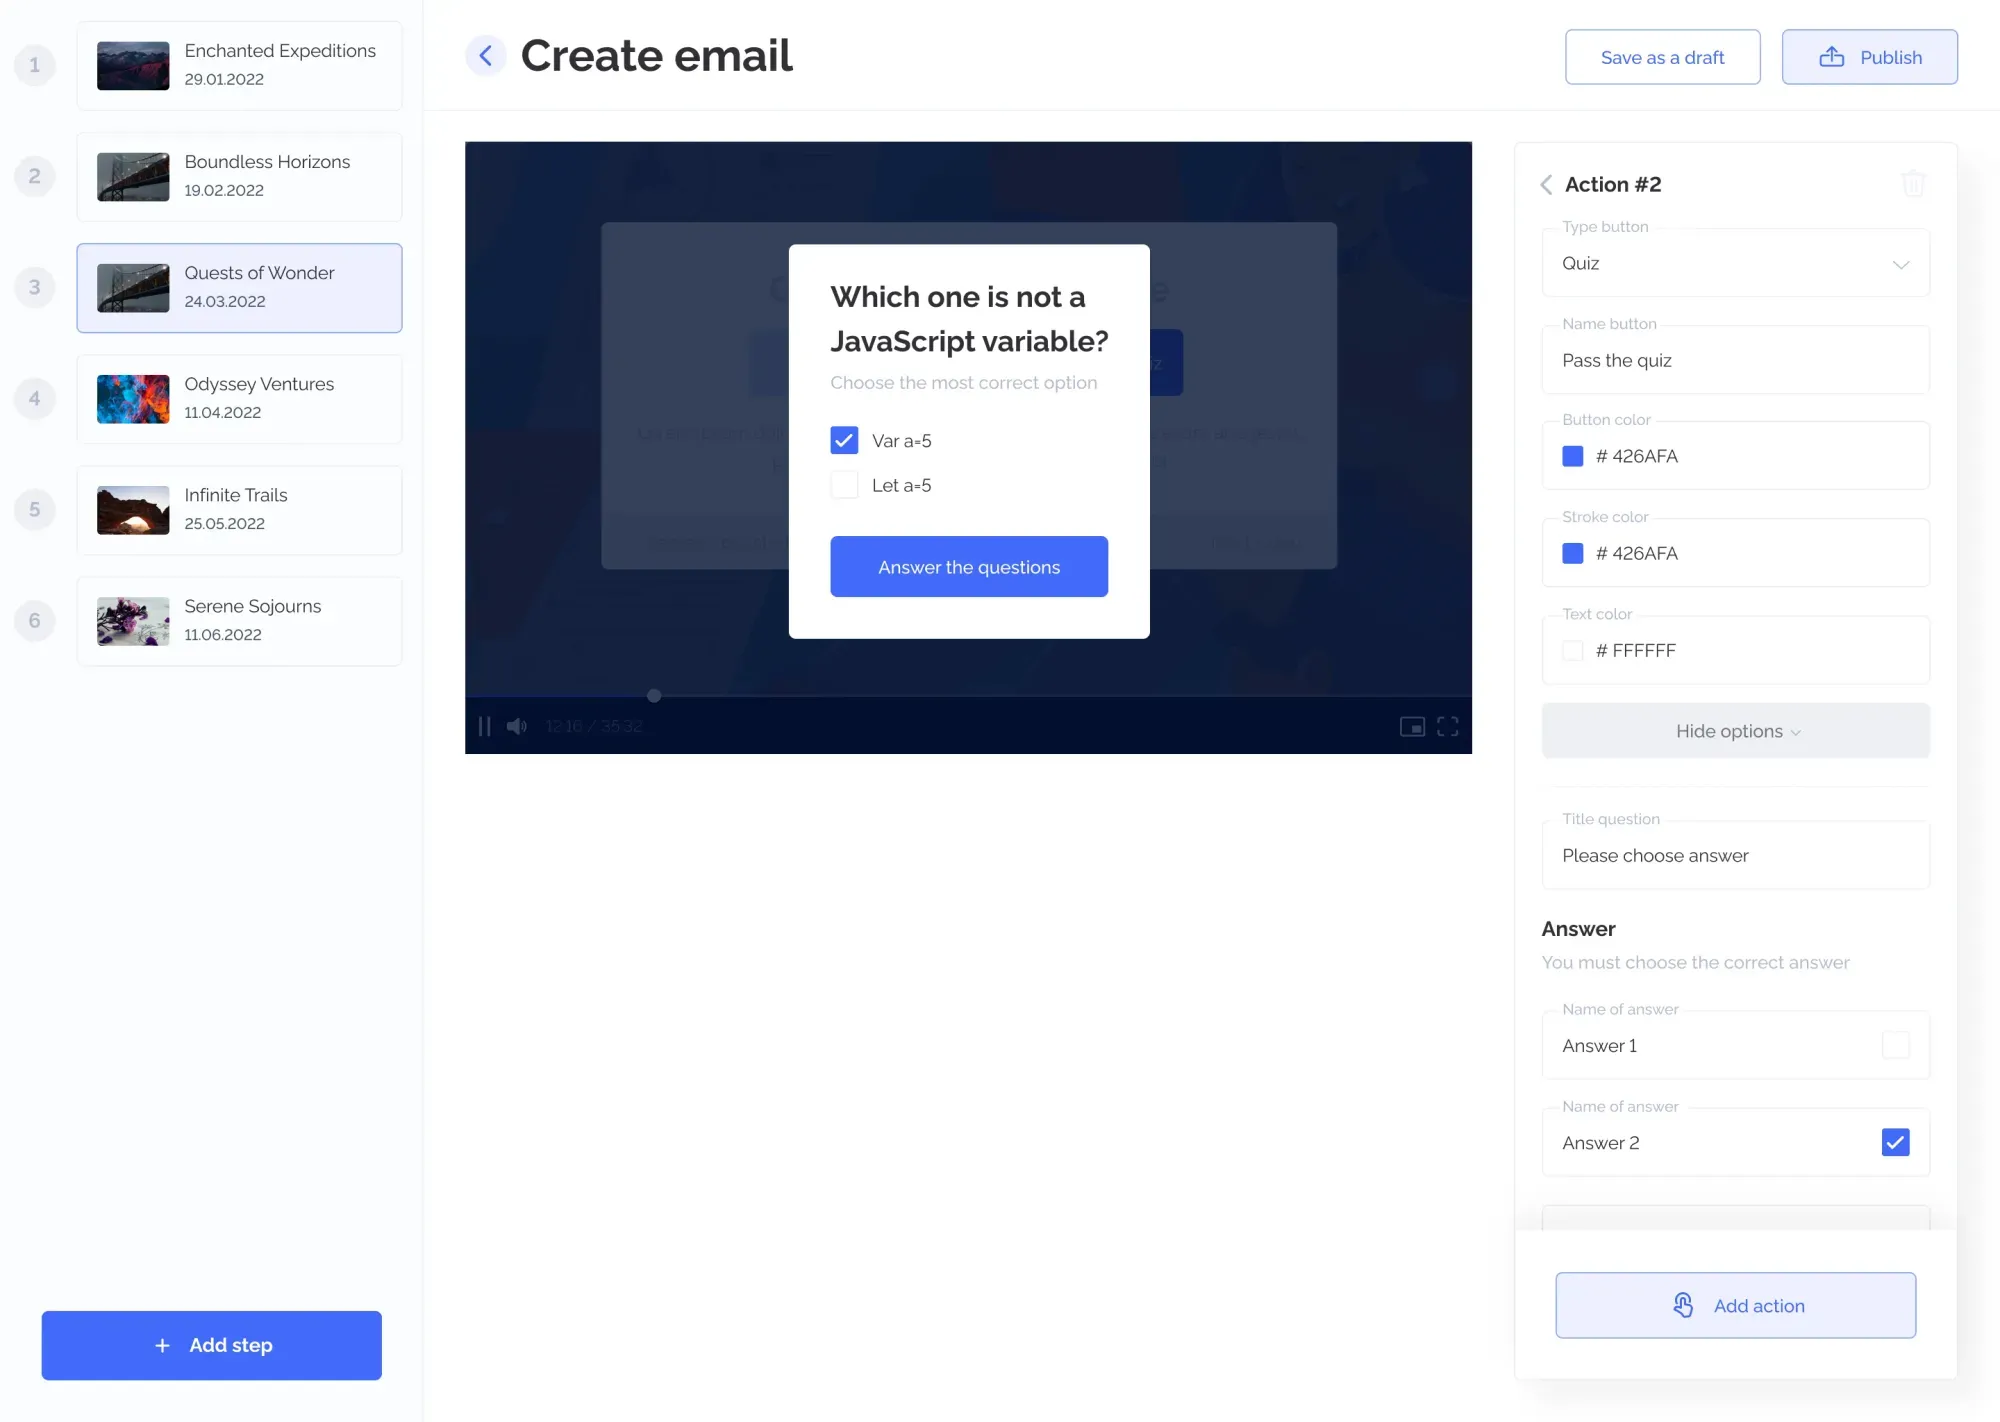
Наприклад, у межах адмін-панелі платформи simpl.cx ми розробили покроковий конструктор маршрутів (Journey Builder), де адміністратор у лівій колонці вибудовує послідовність із 6+ етапів (`+ Add step`), по центру бачить інтерактивне прев'ю модального шлюзу перевірки, а в правій панелі інспектора (`Action #2`) налаштовує тип контрольної точки (`Quiz`), текст питання, варіанти відповідей із прапорцем правильного рішення та кнопки збереження у чернетку (`Save as a draft`) або публікації (`Publish`):
Пояснюваність AI (Explainability): як візуалізувати джерела та логіку прийняття рішень
Досвідчений керівник або профільний спеціаліст ніколи не прийме рекомендацію алгоритму, якщо система видає голе число без доказової бази («Купіть 450 одиниць товару Х» або «Імовірність виграшу 74%»). Щоб подолати скептицизм експертів, інтерфейс зобов'язаний реалізувати патерн Explainable AI (XAI) & Source Lineage — миттєву розшифровку того, на основі яких саме первинних документів, формул і ймовірностей нейромережа дійшла свого висновку.
1. Індикатори впевненості моделі (Confidence Score) та інтерактивні посилання на першоджерела
Коли AI-система генерує аналітичний звіт, резюме юридичного контракту або фінансовий прогноз, ми впроваджуємо три візуальні маркери достовірності:
Клікабельні мікро-цитати (`[Джерело: Договір №42, стор. 7]`): При наведенні курсора на будь-яку цифру чи твердження у згенерованому тексті у бічній панелі (Split-View Drawer) миттєво відкривається оригінал завантаженого PDF-документа або рядок бази даних із підсвіченим маркером абзацом.
Кольорове кодування рівня впевненості (Confidence Badges): Високоточні дані з бази позначаються нейтральним стилем, тоді як оціночні прогнози або місця з неповними вхідними даними маркуються жовтим бейджем `⚠ Оціночне значення (72% впевненості) — перевірте вручну`.
Візуальне розкриття математичної моделі: Якщо продукт використовує складні алгоритми розрахунку шансів, ризиків чи скорингу, сам інтерфейс має наочно пояснювати механіку обчислень.
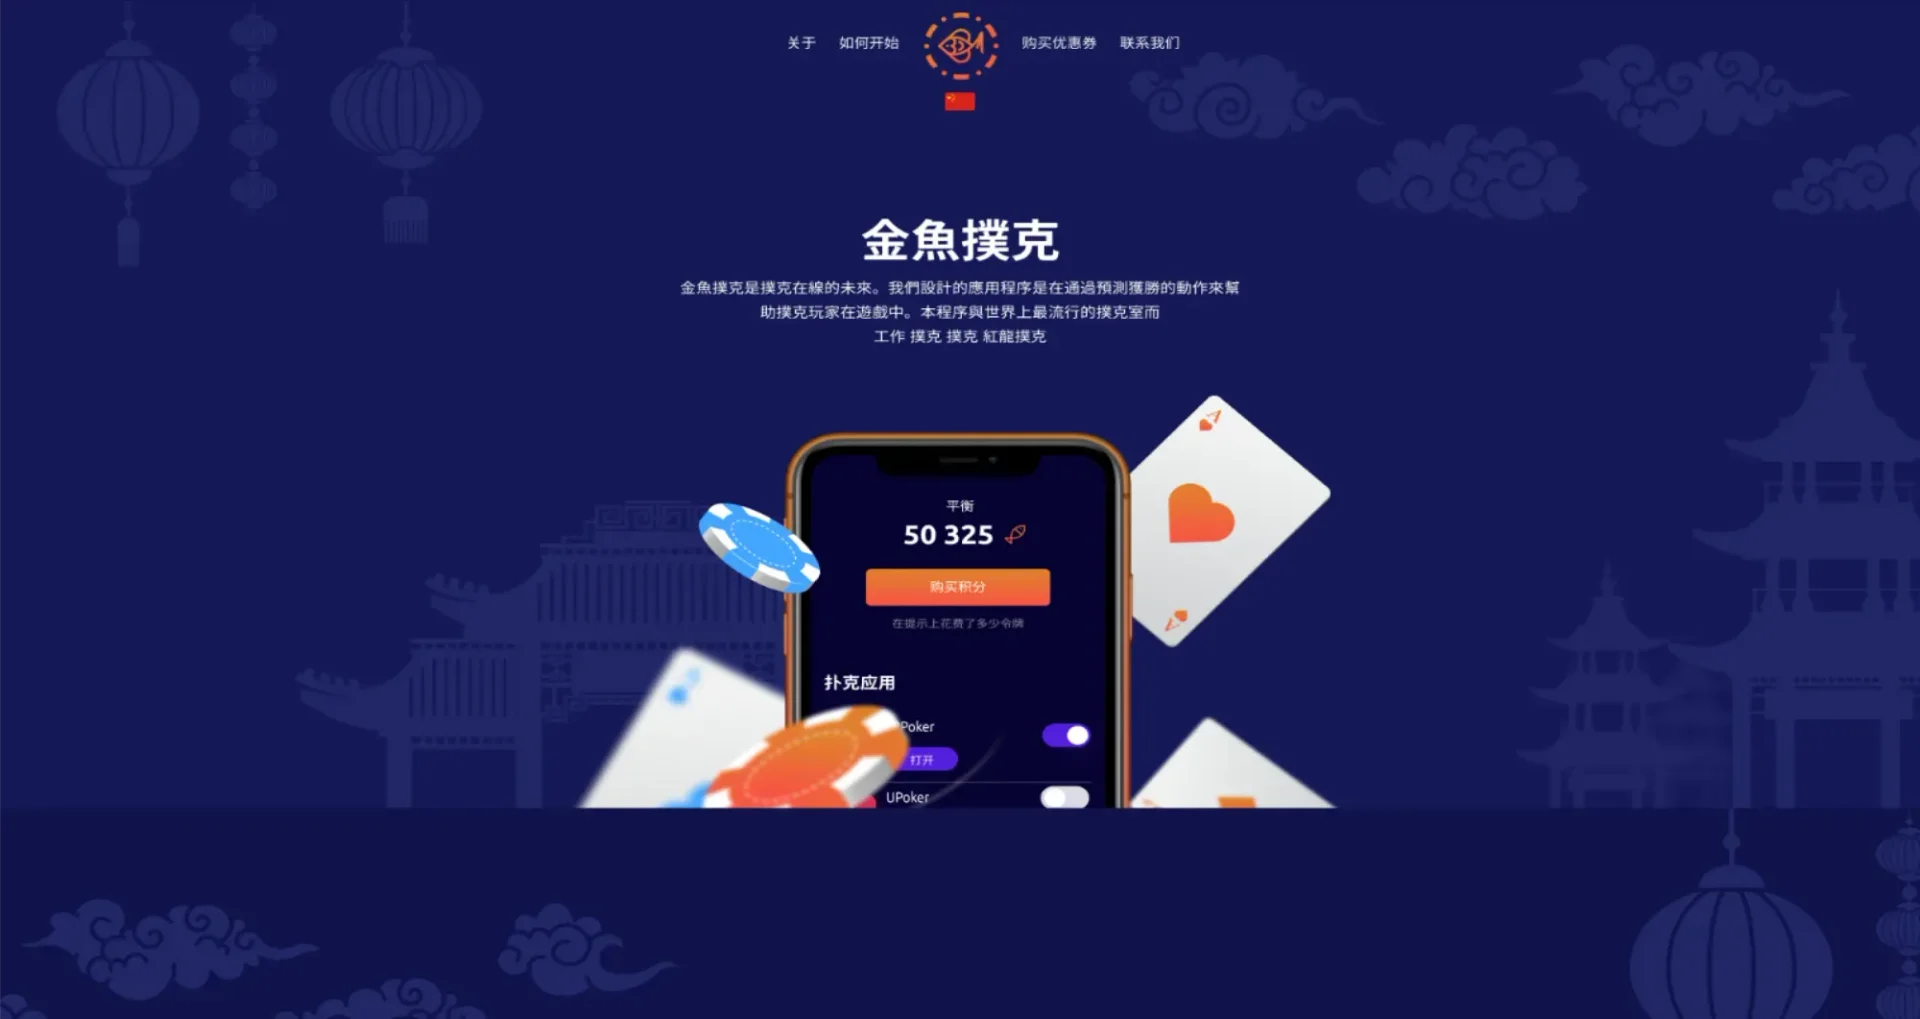
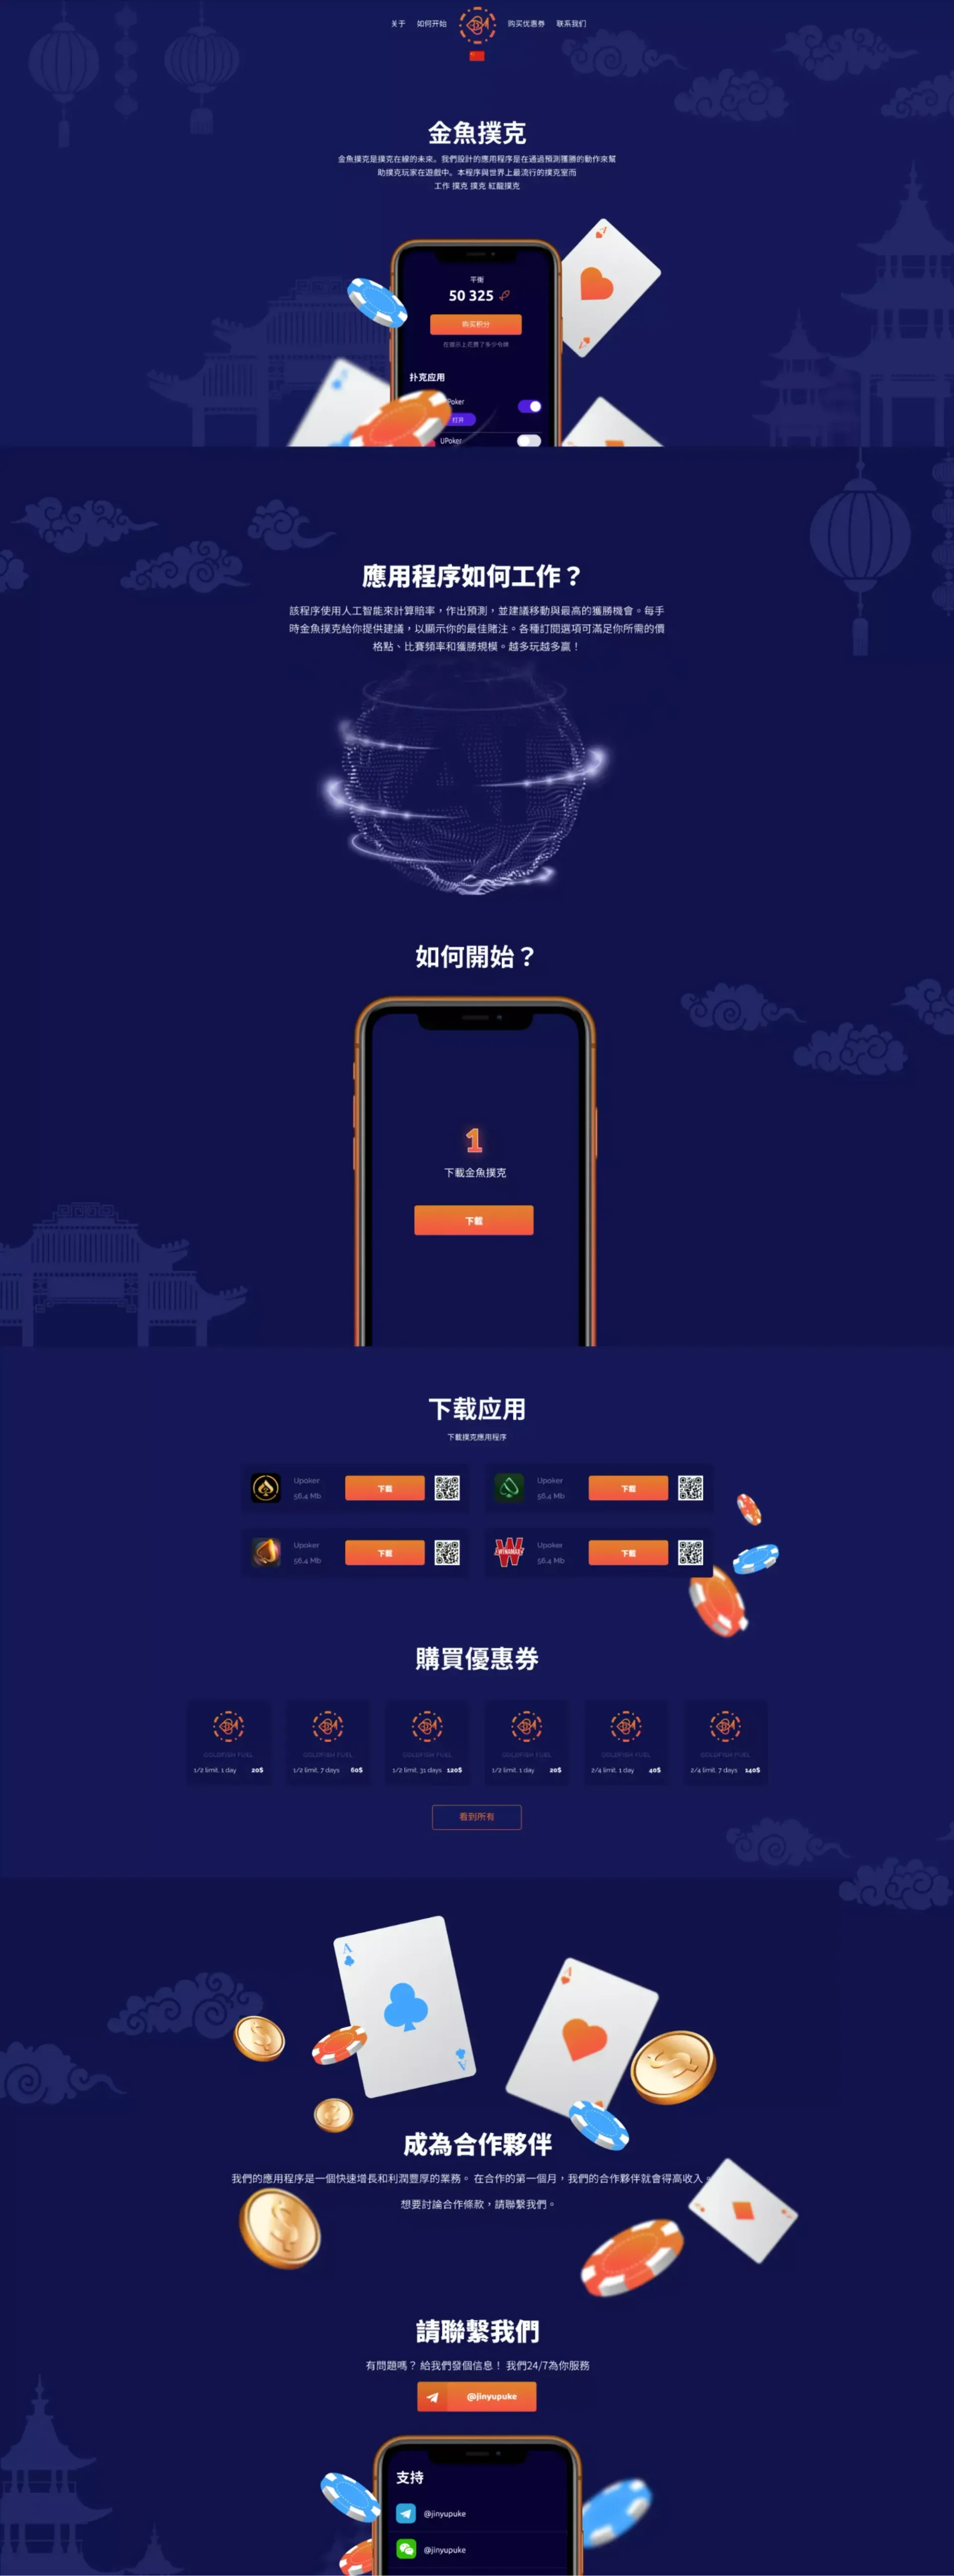
Саме таке завдання візуалізації складної алгоритмічної логіки ми вирішили під час проєктування промо-платформи для мобільного AI-асистента GOLD FISH. Оскільки продукт працює зі статистичним аналізом і прорахунком математичних імовірностей у реальному часі, критично важливо було зняти недовіру користувачів до алгоритму. Вже на головному екрані ми винесли інтерфейс мобільного AI-асистента з індикацією активного балансу (`50 325`) та миттєвими перемикачами ігрових кімнат (`Poker / UPoker`), а далі за структурою сторінки розкрили принцип роботи AI-ядра розрахунку шансів та прозору матрицю тарифних пакетів:
Кейс розробки системи автономної черги: від сирого промпта до контрольованого бізнес-результату
Найвища рентабельність AI у корпоративному сегменті досягається тоді, коли генеративні агенти вбудовуються у конвеєр виконання складних багатоетапних замовлень: збір вимог → автоматична генерація чернетки → перевірка на плагіат і стандарти → рев'ю експертом → поетапне виставлення інвойсів. Давайте розберемо, як правильне проєктування такого конвеєра змінює фінансову модель SaaS-продукту.
Сирий Чат-бот (Chat Wrapper) проти AI-Native інтерфейсу з Human-in-the-Loop (на 2,500 нових тріалів/міс)
- Активація першого результату (Aha-Moment): Лише 22% користувачів пишуть вдалий промпт
- Витрати на LLM-токени (Re-prompting loop): 5.4 генерації на 1 задачу ($16.40 COGS/аккаунт)
- Конверсія з Free Trial у платний тариф: 4.2% (105 платних клієнтів із 2,500 реєстрацій)
- Відтік у перший місяць (Month-1 Churn): 28% через недовіру до неконтрольованих дій AI
- Новий щомісячний дохід (Net New MRR): $8,295 при маркетинговому бюджеті $45,000
- Активація через параметричні пресети: 74% користувачів отримують результат за 60 секунд
- Витрати на LLM-токени (Inline Diff Edit): 1.2 генерації на задачу ($4.90 COGS — економія 70%)
- Конверсія з Free Trial у платний тариф: 14.8% (370 платних клієнтів на тому ж трафіку)
- Відтік у перший місяць (Month-1 Churn): 8.5% завдяки повному контролю Approve / Rollback
- Новий щомісячний дохід (Net New MRR): $29,230 (+252% виручки без збільшення витрат на рекламу)
Перехід від сирого текстового чату до параметричного робочого простору з точковим редагуванням блоків одночасно вирішує дві головні проблеми AI-фаундера: кратно піднімає активацію користувачів і зупиняє безконтрольне спалювання дорогих токенів на повторних генераціях.
1. Архітектура повноцінного робочого простору замовлення та ревізій: кейс Academic Papers
Коли система працює зі створенням складних інтелектуальних документів або досліджень, користувачеві потрібне не вікно чату, а структурований кабінет управління життєвим циклом роботи з чіткими етапами контролю.
Саме таку багатошарову панель управління процесом ми спроєктували для освітньої платформи Academic Papers. Замість хаотичного листування ми побудували спеціалізований робочий простір замовлення, розділений на 6 функціональних вкладок: формалізований паспорт вимог (академічний рівень, стиль цитування APA/MLA/Harvard, дедлайн), прямий канал комунікації з виконавцем і підтримкою, версіонований журнал правок (Revision History), сховище файлів та прозорий реєстр поетапних інвойсів зі статусами оплати за кожну частину роботи:

2. Чек-лист готовності вашого AI-інтерфейсу до масштабування платного трафіку
Перш ніж заливати бюджет у залучення користувачів на ваш AI-продукт або впроваджувати автономну чергу всередині компанії, перевірте інтерфейс за 4 інженерними критеріями:
Правило 60 секунд без клавіатури: Чи може новий користувач отримати перший якісний результат на демо-даних або пресетах за 3 кліки мишкою, не вводячи жодного слова з клавіатури?
Прозорість кожної секунди затримки: Чи бачить людина покроковий прогрес думки агента (`Аналіз` → `Пошук у базі` → `Генерація таблиці`) під час виконання запиту, що триває довше 3 секунд, та кнопку миттєвої зупинки `Stop Generating`?
Ізольоване редагування артефакту: Чи може користувач виділити один абзац або одну клітинку таблиці й попросити AI переписати лише її, не втрачаючи решту 95% затвердженого документа?
Шлюз безпеки перед дією: Чи захищені всі зовнішні вебхуки (відправка email, запис у CRM, виставлення рахунку) обов'язковим екраном попереднього перегляду `Approve / Edit / Reject`? Щоб за 2 хвилини визначити, чи потрібен вашому сервісу повний перегляд архітектури чи точковий UX-спринт, пройдіть діагностику в нашому інструменті Калькулятор «Повний редизайн чи точкові правки».
Головні висновки
Будуєте AI-продукт або автономну систему і хочете перетворити «чорну скриньку» на керований інтерфейс?
До 80–85% AI-продуктів втрачають користувачів через те, що ховають потужну логіку агентів за порожнім текстовим полем чат-бота, перекладаючи промпт-інжиніринг на клієнта.
Заміна вільного текстового вводу на параметричні контролери та пресети скорочує кількість повторних генерацій з 5.4 до 1.2 раза, заощаджуючи до 70% витрат на токени LLM API.
Каскадні скелетони міркувань (Chain-of-Thought Streaming UX) утримують увагу користувача під час 10–30 секундних затримок, знижуючи показник відмов у 9 разів.
Впровадження шлюзів схвалення Human-in-the-Loop (Approve / Diff Edit / Rollback) знімає страх фатальної помилки нейромережі та піднімає конверсію Trial-to-Paid з 4.2% до 14.8%.